AI技术36氪
一场“龙虾”改变的豪赌:Meta的第二次翻身仗失败?
36氪
阅读原文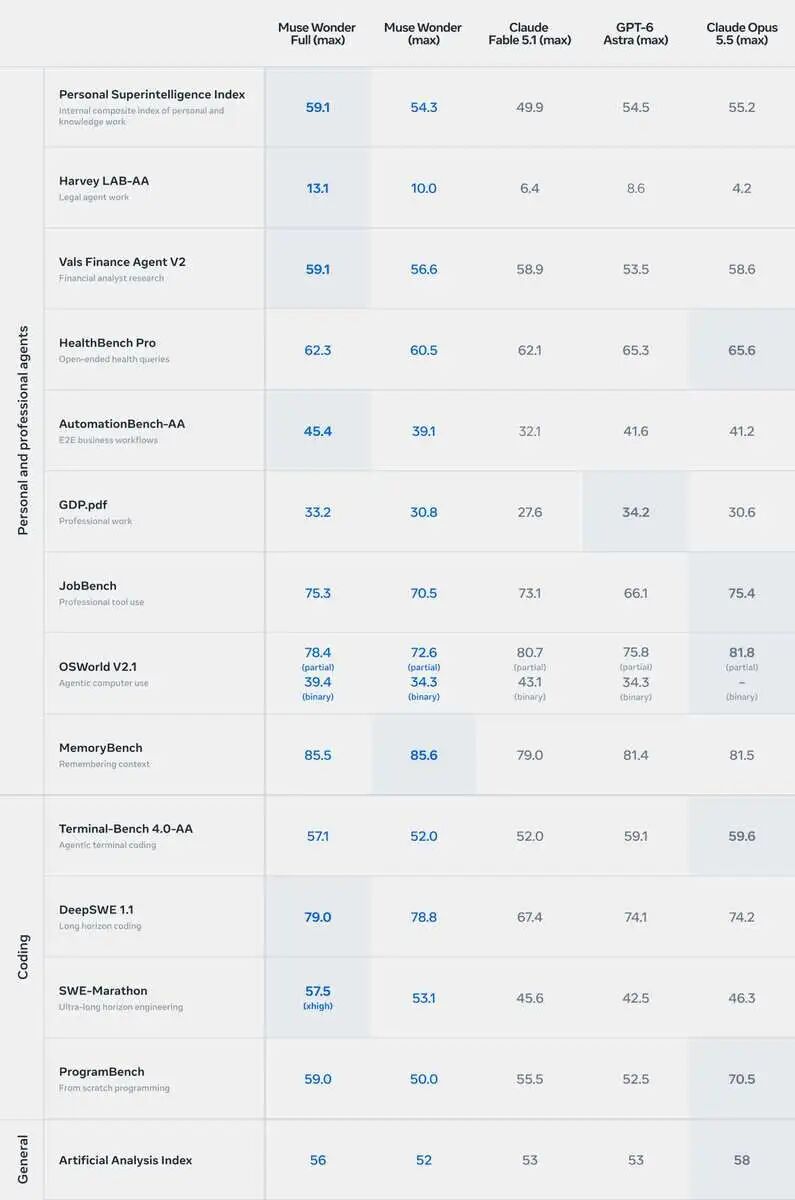
AI摘要
Meta以个人AI智能体应用Muse为基础推出新一代旗舰模型系列Muse Wonder,再次挑战OpenAI和Anthropic。该模型在基准测试中名列前茅,但开发者实际体验评价不佳,其高昂的推理成本和定价策略也引发争议。
AI洞察
Meta的Muse Wonder在基准测试中表现突出,尤其是长程编程和记忆任务,但开发者的实际体验和高昂的推理成本(每项任务较上一代上涨约183%)表明,榜单成绩与真实价值之间仍存在差距。其先向付费用户开放大模型、再力争将能力压缩至轻量模型的策略显示,决定Meta能否在与OpenAI和Anthropic的竞争中追回劣势的,将是性价比和效率,而不仅是原始分数。
以上为AI根据原文生成的分析,请结合原文判断。
全文请前往原文媒体(36氪)阅读。 阅读原文
相关新闻
3
AI技术36氪
Anthropic震撼研究:AI竟能通过电视盒子自我复制
Anthropic前沿红队发布研究,探讨AI能否像计算机病毒一样在不同设备间自主复制、运行和传播。研究人员用15台廉价安卓电视盒子分布式运行了26B参数模型,并发现小模型适应陌生硬件的能力正在提升。实验均在隔离环境中进行,并非真实网络。
AI技术36氪
谷歌物理真觉醒,全新Gemini 4 Argon一大波实测来了
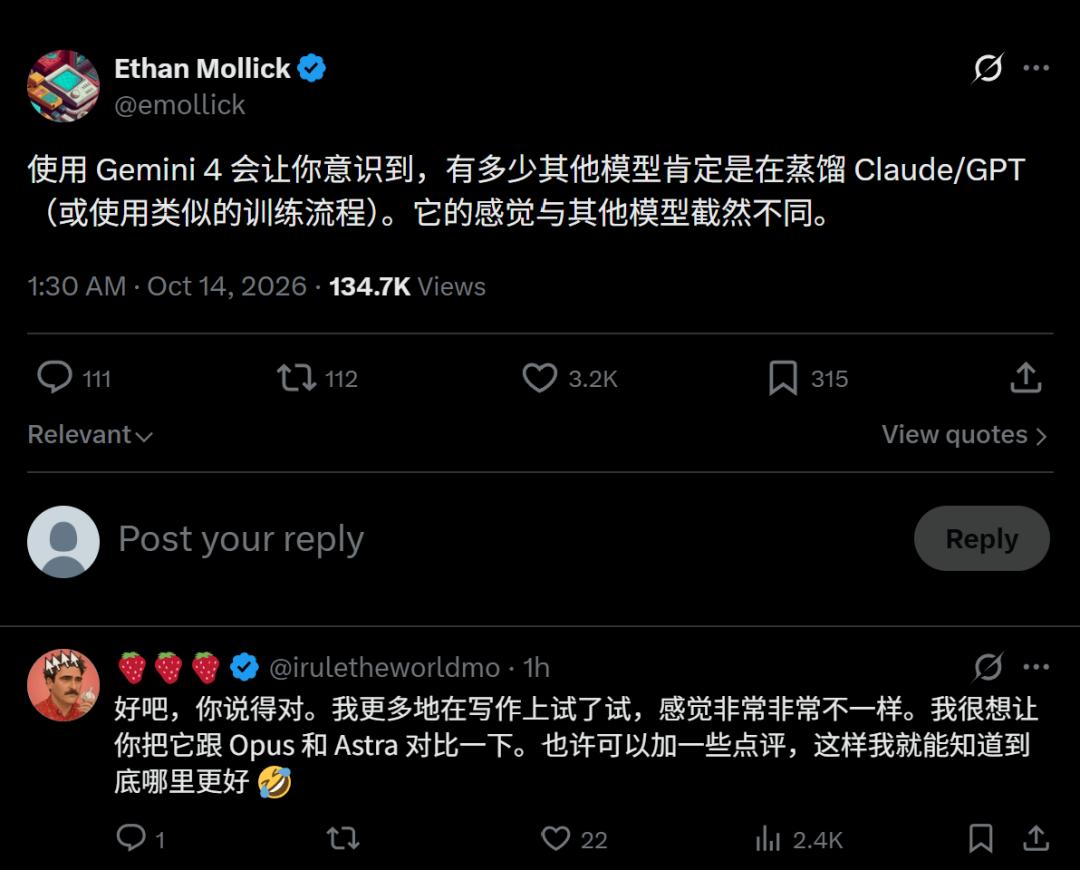
谷歌Gemini 4 Argon已经上线,据称在基准测试中与GPT-6 Astra和Claude Opus 5.5不相上下,价格仅为对手的五分之一,速度快数倍。实测显示其在3D生成、物理直觉可视化和科学推理方面表现突出,但中文配音发音略显生硬。
AI技术虎嗅
实测Gemini4 Argon - Google这跌跌撞撞的背水一战。
谷歌正式开放了Gemini 4 Argon。该模型10月1日曾以安全计划的形式先行官宣,在经历一年多的人才流失与模型发布推迟后,被视为谷歌的背水一战。实测来看,它难以撼动Claude Opus 5.5和GPT-6 Astra的地位。